

WeKnora:腾讯开源的 LLM 知识平台,把一堆文档变成会自己长大的知识库
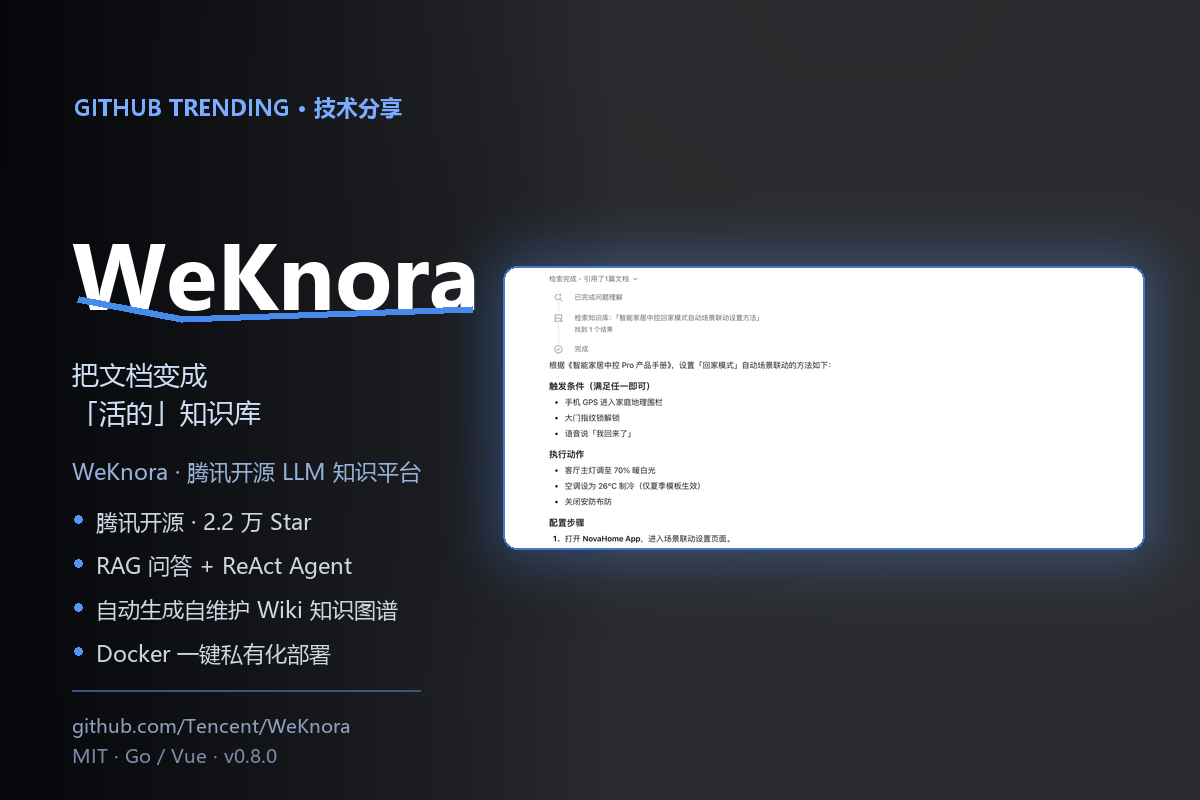
GitHub Trending 上又出现了一个「文档进、答案出」型的国产开源项目。这次是腾讯开源的 WeKnora —— 目前 2.2 万 Star,最近一次更新是 2026-09-13,最新版本 v0.8.0(2026-09-03 发布)。它的目标很明确:把散落各处的原始文档,变成可查询的 RAG 知识库、能自主推理的 Agent,以及一座会自动维护的 Wiki。
官方仓库地址:github.com/Tencent/WeKnora,官网:weknora.weixin.qq.com。
一句话说清它是什么
市面上的「知识库 + 大模型」方案,大多停留在「上传 PDF,然后问答」。WeKnora 想做的事情更靠前一步,它同时提供了三种能力,并且让这三种能力互相喂养:
- Quick Q&A(快速问答):基于 RAG 的常规检索问答,适合日常查资料。
- ReAct Agent(智能体模式):让模型自己决定要不要检索、要不要调工具、要不要写代码,用多步推理处理复杂任务。
- Wiki Mode(Wiki 模式):这是个比较少见的能力——Agent 会把你上传的原始文档蒸馏成结构化的、互相关联的 Markdown 页面,并生成一张可交互的知识图谱。而且这些页面支持在浏览器里直接手改、看历史版本、逐行 diff、一键回滚。
也就是说,它不是让你去翻文档,而是自己把文档「消化」成一套能读的知识体系。
v0.8.0 带来的新东西
这个项目的迭代节奏相当快,最近几个版本的改动量都不小。v0.8.0 的几个重点:
- 技能沙箱运行时(Skill Sandbox):支持会话级的 Docker / E2B / Cube 三种沙箱后端,并且按租户配置网络策略。注意,本地宿主机进程后端已经被移除,Docker 模式需要显式开启。
- 租户级技能目录(Skill Catalog):可以从 ClawHub / SkillHub / git / zip 安装技能,每个沙箱有快照,支持进度实时查看、文件浏览编辑,以及个人级和工作区级的环境变量。
- 跨会话长期记忆:把记忆分成画像、偏好、事实、任务、兴趣几类,自动抽取并等待用户确认,使用时通过
search_memory按需召回。 - 进程内 anydoc 办公文档解析器:Office 文件不再需要额外的外部服务。
- 官方 DeepSeek Harness 插件
@wxg-prc-cpg/dsh-weknora,以及 GitLab、腾讯 IMA 数据源,LiteLLM 支持,Exa / Metaso 网页搜索,XMind 解析等。
如果你只是想先跑起来看看,v0.8.0 的能力已经足够完整了。
核心能力拆解
1. 文档解析:格式和数据源都很能打
直接说支持范围:
- 文档格式:PDF、Word、TxT、Markdown、HTML、EPUB、MHTML、图片、CSV、Excel、PPT、JSON、XMind,共 10 多种。
- 外部数据源自动同步:飞书知识库、飞书云文档、Lark、GitLab、腾讯 IMA、Notion、语雀、RSS 订阅,支持增量和全量同步。
这一点对企业用户意义很大——大部分知识不在本地文件夹里,而在飞书、语雀、GitLab 这些协作工具里。WeKnora 是直接把数据源接进来,而不是让你手动导。
2. 知识管理:像个文件管理器,而不是「一堆碎片」
比较实用的几个细节:
- 目录树保留上传结构:上传文件夹时会保留原始目录层级,侧边栏可以像文件管理器一样浏览、重命名、把文档移动到别的文件夹。
- 切片编辑与版本历史:检索用的 chunk 可以直接在界面上编辑,每个版本有快照、支持 diff 和一键回滚,改完自动重建索引。
- 按批次覆盖解析配置:上传确认弹窗里可以逐批指定解析器、分块策略、多模态(VLM / ASR)、图谱抽取、问题生成等参数,之后也能用新的配置重新解析。
- 检索策略:BM25 稀疏检索、稠密检索、GraphRAG、父子分块、HNSW 加速的 pgvector(1024 维)多维索引。
3. 集成生态:模型、向量库、IM 都能换
这部分是它「模块化」主张最直接的体现:
| 类别 | 支持的实现 |
| LLM | OpenAI / Azure OpenAI / Anthropic Claude / DeepSeek / 通义千问 / 智谱 / 混元 / 豆包 / Gemini / MiniMax / NVIDIA / Novita AI / SiliconFlow / OpenRouter / LiteLLM / Ollama |
| Embedding | Ollama / BGE / GTE / 智谱 / OpenAI 兼容接口 |
| 向量数据库 | PostgreSQL(pgvector) / Elasticsearch / OpenSearch / Milvus / Weaviate / Qdrant / Apache Doris / 腾讯 VectorDB |
| 对象存储 | 本地 / MinIO / AWS S3 / 腾讯云 TOS / 阿里云 OSS / 金山云 KS3 / 华为云 OBS |
| IM 通道 | 企业微信 / 飞书 / Lark / QQ 机器人 / Slack / Telegram / 钉钉 / Mattermost / 微信 / 云之家 |
模型层的「每个知识库可以单独选模型」这点挺关键——你可以让内部资料走本地 Ollama,让公开资料走云端 API。
4. 面向 AI 编程助手的接口
比较有意思的一块:WeKnora 不只是一个 Web 应用,它同时对外暴露了给 Agent 用的入口。
- 官方 MCP Server:PyPI 包
tencent-weknora-mcp,提供 29 个工具,支持 stdio / SSE / HTTP 三种传输方式。 - CLI:
weknora命令行工具是「agent-first」设计的,默认输出稳定的 JSON 信封结构,错误码映射到退出码;--format text才给人看。它也自带 MCP 服务(weknora mcp serve)和内置的 Agent Skills。 - DeepSeek Harness 插件:装上后会往编程助手的工具集里加四个只读工具——
weknora_search(混合检索,返回原文片段和可复用的knowledge_id)、weknora_read_document(按顺序还原整篇文档,支持分页)、weknora_ask(带引用的问答,可走 RAG 或 ReAct 管道)、weknora_list_knowledge_bases(列出知识库供 Agent 自己限定检索范围)。
也就是说,你可以让自己的编程助手直接「拥有」你的内部文档。
5. 企业级:权限、审计、可观测性
- 多工作区 RBAC:四层角色矩阵 Owner / Admin / Contributor / Viewer,加上每个知识库的资源归属和按工作区隔离的审计日志。
- 范围化 API Key:能力级授权 + 按知识库限制 + 限流的最后使用时间追踪。
- 安全:API Key 与 MCP / 数据源凭据用 AES-256-GCM 静态加密并支持密钥轮换;app 与 docreader 之间的 gRPC 走 TLS + Token;Redis TLS;防 SSRF 的 HTTP 客户端(数据源、URL 导入、重定向链都会被检查);响应中的敏感信息脱敏;OIDC ID Token 的 JWKS 校验。
- 可观测性:集成 Langfuse 作为唯一追踪后端,覆盖 ReAct 循环、Token 统计、工具调用和管道追踪;还有一套 Langfuse 风格的文档解析链路时间线,能看到逐阶段进度。
- 任务队列:分阶段的工作池治理(core / post-process / enrichment / maintenance + 弹性共享池,Wiki 有独立池),加上按模型的并发控制器,管理员面板可以查看队列深度和失败任务并手动重试。
五分钟跑起来
只要机器上有 Docker 和 Git:
git clone https://github.com/Tencent/WeKnora
cd WeKnora
cd WeKnora
cp .env.example .env   # 按需修改,文件里有注释
docker compose pull    # 拉取最新镜像
docker compose up -d   # 启动核心服务
启动后访问 http://localhost 就能用。如果要接本地的 Ollama,先执行 ollama serve > /dev/null 2>&1 &。
需要附加组件时用 Docker Compose Profile 组合:
| Profile | 作用 | 命令 |
| (默认) | 核心服务 | docker compose up -d |
full |
全部功能 | docker compose --profile full up -d |
neo4j |
知识图谱 | docker compose --profile neo4j up -d |
minio |
对象存储 | docker compose --profile minio up -d |
langfuse |
链路追踪 | docker compose --profile langfuse up -d |
服务端口:Web UI http://localhost,后端 API http://localhost:8080,Langfuse 追踪 http://localhost:3000。
如果是要改代码的开发模式,不用反复重建镜像:
make dev-start        # 启动基础设施
make dev-app          # 启动后端(新终端,Air 热重载)
make dev-frontend     # 启动前端(新终端,热更新)
版本节奏与工程细节
从 CHANGELOG 看,这个项目的发布密度大约是每两到三周一个版本,而且每个版本都是实打实的功能增量,不是版本号游戏:
- v0.8.0(2026-09-03):技能沙箱 + 技能目录 + 长期记忆 + anydoc。
- v0.7.2(2026-08-07):官方文档站(VitePress,约 50 页、覆盖约 360 个 API 端点)、知识库目录树、切片编辑与修订历史、Wiki 页面修订历史。
- v0.7.1(2026-07-24):云之家 IM 集成、火山引擎 rerank、平台级 API Key、Langfuse OTLP 追踪迁移。
- v0.7.0(2026-07-17):范围化 API Key 与主体模型、任务队列可观测面板、多实例存储后端。
- v0.6.0:工作区 RBAC 四层角色矩阵、AES-256-GCM 凭据加密、Go 1.26.0。
- v0.5.0:Wiki 模式 GA。
技术栈上,后端是 Go,前端是 Vue,架构上「解析 → 向量化 → 检索 → LLM 推理」每一步都可替换。项目采用 MIT 协议,代码可以自由使用、修改和分发。
部署前要注意的安全提醒
官方在 README 里专门加了一段安全声明,这点值得照抄过来:从 v0.1.3 起 WeKnora 才加入了登录认证。生产环境部署时建议:
- 把服务部署在内网或私有网络环境,不要直接暴露在公网;
- 避免把服务端口直接开放到互联网,防止信息泄露;
- 配置好防火墙规则和访问控制;
- 定期升级到最新版本以获取安全补丁。
考虑到它挂载的往往是企业内部文档,这一条比功能列表更值得先看。
值不值得上手
适合你的场景:团队有一堆散落在飞书 / 语雀 / GitLab / 本地的文档,想要一个能私有化部署、能接自己的模型、还能让 AI 编程助手直接检索的知识底座;或者你单纯想看看「RAG + Agent + 自动 Wiki」这三件事怎么在一个工程里被缝起来。
可能不太适合:只想给个人笔记做个简单问答、不想碰 Docker 的人;或者对「数据绝不离开本机」有极致要求、希望完全零外部依赖的场景(WeKnora 虽然支持本地 Ollama 和本地存储,但组件数量摆在那里)。
它真正的差异化在Wiki 模式和Agent 可接入性这两点上,其余的 RAG 能力市面上并不缺。如果你的痛点恰好是「文档太多、没人整理成体系」,这个项目的思路值得认真看一眼。
项目信息速览
- 仓库:https://github.com/Tencent/WeKnora
- 官网:https://weknora.weixin.qq.com
- 协议:MIT
- 技术栈:Go + Vue,Docker Compose / Kubernetes(Helm) 部署
- 最新版本:v0.8.0(2026-09-03)






暂无评论内容