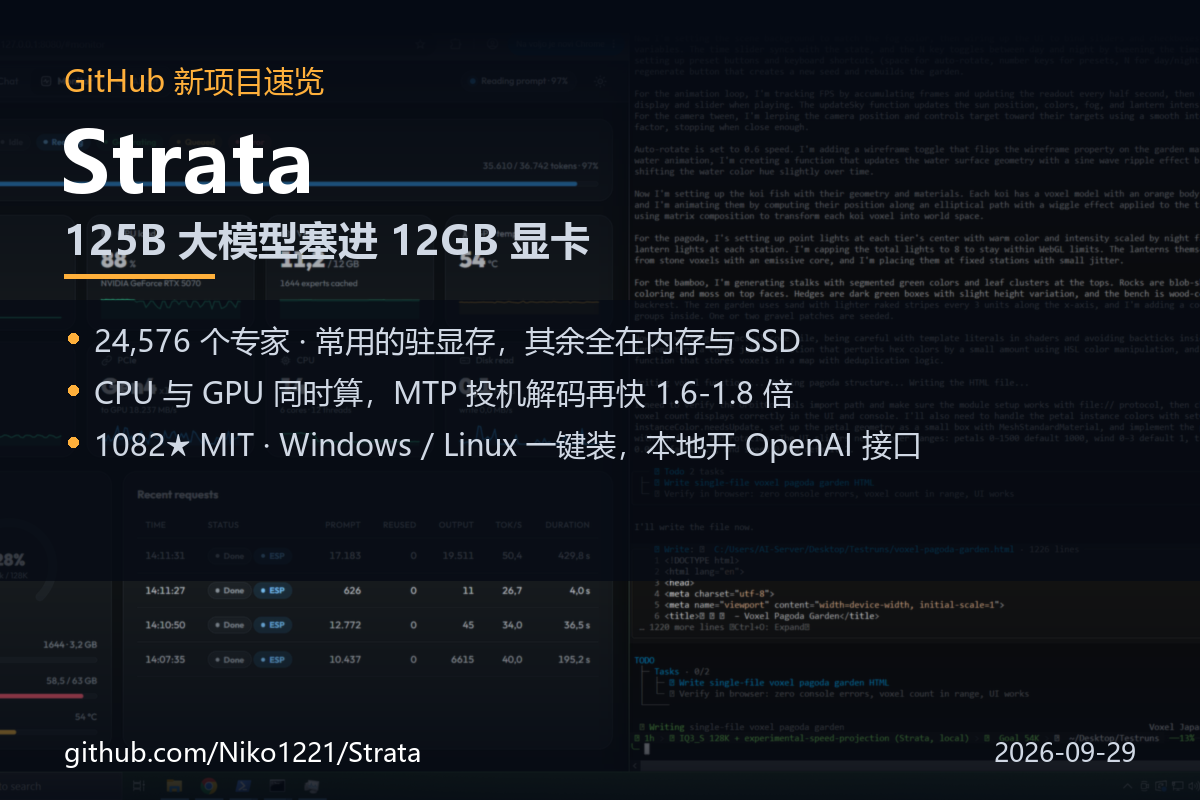


一台普通游戏 PC,一块 12GB 显存的 RTX 卡,能不能跑一个 1250 亿参数的大模型?按常理这中间的差距不是一点半点——这类模型平时待在几百 GB 显存的服务器里。但 GitHub 上前几天冒出来的一个 C++ 项目 Strata 说:可以,而且 Windows 和 Linux 都是双击一个脚本就装完。
它跑的是 Qwen3.8-Flash-Next,一个 125B 参数的 MoE(混合专家)模型。在作者的 RTX 5070(12GB)机器上,实测输出速度能到 50-90 tokens/s,128K 上下文也还有 40-67 tokens/s,比人读得快。项目 9 月 24 日建仓,几天就冲到 1000 多 star,用的还是 MIT 许可。我把它的 README、源码结构和论文都翻了一遍,这篇文章说清楚它到底动了哪些手脚。
它是什么:把服务器级模型塞进家用机
项目的目标很直接:让你在一块 NVIDIA 显卡(12-24GB 显存)+ 64GB 内存的机器上,跑起一个原本需要服务器的大模型。安装只需自己装好显卡驱动,剩下的 Python、引擎、模型全部由脚本代劳。装完浏览器自动打开 http://127.0.0.1:8080,是一个带 Chat、实时 Monitor(盯着模型和 GPU/CPU/内存)和 About 的本地应用。
更关键的是它对外就是一个本地 API:把它当成「OpenAI 兼容」的 provider,base URL 填 http://127.0.0.1:8080/v1,随便填个 API key 和模型名,你现有的应用和编程 Agent 就能直接用上这个本地大模型;用 Anthropic 接口的,地址是 http://127.0.0.1:8080/v1/messages。
核心思路:把模型拆成「厨房」
为什么 125B 的模型能塞进 12GB 显卡?因为它是 MoE 架构,模型里其实是 24,576 个小专家(expert),而写每一个字只需要其中 10 个。所以根本不用把所有专家都同时放进显卡。作者用的比喻是一间厨房:天天用的东西放台面上,其余的都放储藏间。
具体到硬件分工是这样的:
- 显卡负责每个字都绕不开的那部分计算,同时缓存最常被问到的几千个专家,而且会边用边学哪些专家最热门(这就是动态的 expert cache);
- 内存里放着全部 24,576 个专家,而且是 pinned(锁定)的。当某个字需要显卡上没有的专家时,CPU 就地把它算掉——和显卡并行,谁也不等谁;
- SSD 里放着一张 28.8GB 的 n-gram 表,每个 token 只读几小行。
这套 CPU + GPU 同时干活的设计,是它能跑起来的根本原因。显卡算的时候 CPU 不闲着,这在带宽受限的场景里非常划算。
再快一截:先猜再验的投机解码
除了拆专家,Strata 还用了一招投机解码(speculative decoding)。模型自带的 MTP 层会先「猜」出接下来最多 3 个 token,然后用一次完整的前向计算出所有 48 层,把这些猜测一次性验证——猜对的就留下,出错的那一步再由大模型自己写。所以一个解码步常常能产出好几个字。
作者强调猜的只是「猜测」,每一个字最终都由大模型自己决定,所以答案质量和原模型一致,只是快了 1.6-1.8 倍。引擎 0.1.7 之后还加了一个后缀草稿器(suffix drafter),能从更早的文本副本里一次草拟 5 个 token,但只在实测接受率和成本划算时才用——代码编辑场景因此又快了 6-11%。
长上下文:KV 缓存也能「搬到内存」
上下文越长,KV 缓存越吃显存,留给专家的空间就越少。Strata 从引擎 0.1.5 开始支持 KV streaming:64K 以上时,把整个上下文的 KV 缓存留在内存里,只在显存里放注意力真正要读的那部分(--kv-resident 32768)。这样一来能塞进显存的专家多了,Q2_0 在 262K 上下文下速度从 50.9 提升到 62.6 tokens/s(显存里的专家从 1,589 涨到 3,872 个)。代价是每 token 约 13.7KB 内存,128K 时约 1.7GB。作者特别说明:注意力读到的值完全一样,只是 KV 存在哪儿变了。
0.1.8 还提供了一个可选的 4-bit KV 缓存:用一次 Hadamard 旋转再做 4-bit 舍入,把 KV 缓存内存砍半、128K 时快约 4%,但在长文档上会损失精度(perplexity +8-12%,针尖测试仍然全过)。默认还是 8-bit,怕麻烦就别动它。
工程细节:把预填充速度翻倍
0.1.13 版本对长提示词做了系统性提速,几个改动都挺实在:
- 提示词一次读入的块从 2,048 tokens 提到最多 8,192 tokens(
--prefill auto自动选最大的能放下的块); - 专家乘法改用 llama.cpp 的量化 MMQ 内核,不再先展开成 FP16;
- 下一层的专家通过 PCIe 传输时,当前层的注意力同时在算——流水线重叠;
- PLE 块整块一起算,未 pinned 的专家交给辅助线程拷贝。
结果:在作者的 RTX 5070 12GB、64GB 内存上,32K 提示词的处理速度 Q2_0 从 572 提到 1,290 tokens/s,IQ3_S 从 383 提到 1,208,几乎翻倍。而且输出速度不受影响。
能跑多快:实测数据
作者在 RTX 5070(12GB)、Ryzen 5 7600(6 核)、64GB DDR5-5200 的 Windows 机器上跑了完整的基准。输出速度(tokens/s)大致是:
| 压缩档位 | 内存+显存需求 | 短对话 | 128K 上下文 | 质量 |
|---|---|---|---|---|
| Q2_0 | 37.6 GB | 90 | 67 | good |
| IQ2_XS | 39.2 GB | 74 | 60 | 更好(推荐) |
| IQ3_XXS | 47.0 GB | 62 | 46 | great |
| IQ3_S | 54.8 GB | 52 | 41 | 最好 |
显存更大的卡会更快,因为更多专家能常驻显卡:作者估计 RTX 3090(24GB)大概能跑到 100-140 tokens/s。注意这些数字是「同一模型压得更狠或更松」的档位,不是不同模型。
可选模型:Coder 版与 Swift 1.5
除了原版,还有两个可选项。一个是 ISTA-DASLab 的 Coder 版:砍掉一半专家、只留写代码和工具调用需要的那些,作者称它能保留原版 91% 的 SWE-bench Verified 分数、99% 的 LiveCodeBench。它只有 IQ1_M 一个档位(29.6GB),32GB 内存的机器就能跑,长提示词读得最快。另一个是 UkisAI 的 Swift 1.5,回答前思考得更短,让你更快拿到答案,质量基本不变。
代码结构:这是一套真的推理引擎
之所以说它不是一个套壳,看源码结构就明白了。仓库里 300 多个文件,光是 src/ 和 include/ 下就有一整套推理内核:
src/kernels/cuda/下几十个 CUDA 内核:flash attention、MoE、router、RoPE、GDN、KV 的 q4/q8、sampler,还有专门为 MTP 验证写的 verify_kernels;src/kernels/cpu/里是针对 AVX2 和 AVX-512 手写的专家内核(iq_avx2.cpp、iq_avx512.cpp)和线程池;- 成对的 parity 测试:每个内核都有对应的
*_parity.cpp,保证 CPU 版和 GPU 版算出来的结果一致; tools/里是权重打包工具(gguf_reader.py、iq_pack.py、strata_pack.py),加上一套校准工具calibrate.py——它会在你的机器上试几组引擎设置,把最快的留下(作者的机器上让 Coder 快了 7%);docs/paper/Strata-Paper.pdf是一篇完整的技术论文,带全部测量数据。
它还借鉴了 llama.cpp / ggml(MIT)和 Splash、ninfer、HyperQwen 的思路,这些都在 README 的致谢里写清楚了。
怎么开始
需要的硬件:NVIDIA RTX 30 / 40 / 50 系,显存 12GB 以上,内存够装你选的档位(见上表),约 80GB 空闲磁盘(强烈建议 NVMe SSD),Windows 10/11 或 Linux。唯一要你自己装的是最新的 NVIDIA 驱动。
- 下载项目压缩包解压,或者
git clone; - Windows 双击
START-HERE.bat(Linux 跑./setup.sh); - 回答几个问题:选哪个模型和档位、要多长上下文、要不要读图——不确定就一路回车用推荐值;
- 等它下载模型(约 70GB,第一次要久一点,可以中断、下次接着下),完成后浏览器自动打开应用。
作者在 README 里很实在地提醒:模型启动时电脑可能卡住或假死 1-3 分钟(第一次最久),因为要把 35-55GB 数据装进内存并为显卡锁定一部分——这是正常的,等它跑完就好,别关窗口。之后再次启动会快很多。
已知限制:一次只处理一个请求;KV 缓存里同一时间只保留一段对话的历史;在 WSL 下能跑但会慢一些,因为驱动只能固定约 1GB 内存,KV streaming 用不了。
要不要试试
如果你手上正好有一块 12GB 以上的 N 卡,又想在自己机器上完整体验一次「大模型本地推理」,Strata 算是近期最省心的一条路:不用配 Python 环境、不用手动折腾量化、装完就有 OpenAI 接口可以直接接到现有工具里。需要留意的是模型文件不小(70GB 起)、第一次启动比较慢,建议先看 README 里的故障排查表再动手。
项目地址:https://github.com/Niko1221/Strata (MIT 许可,模型文件各自遵循其自身许可)






cqlbgzs@163.com 1年前0
d好879445037@qq.com 2年前0
购买了 无法下载Alexcc 3年前0
强大Alexcc 3年前0
看不了教程Alexcc 3年前0
雷刺下载Alexcc 3年前0
下载Alexcc 3年前0
下载dsa456159 3年前0
下载