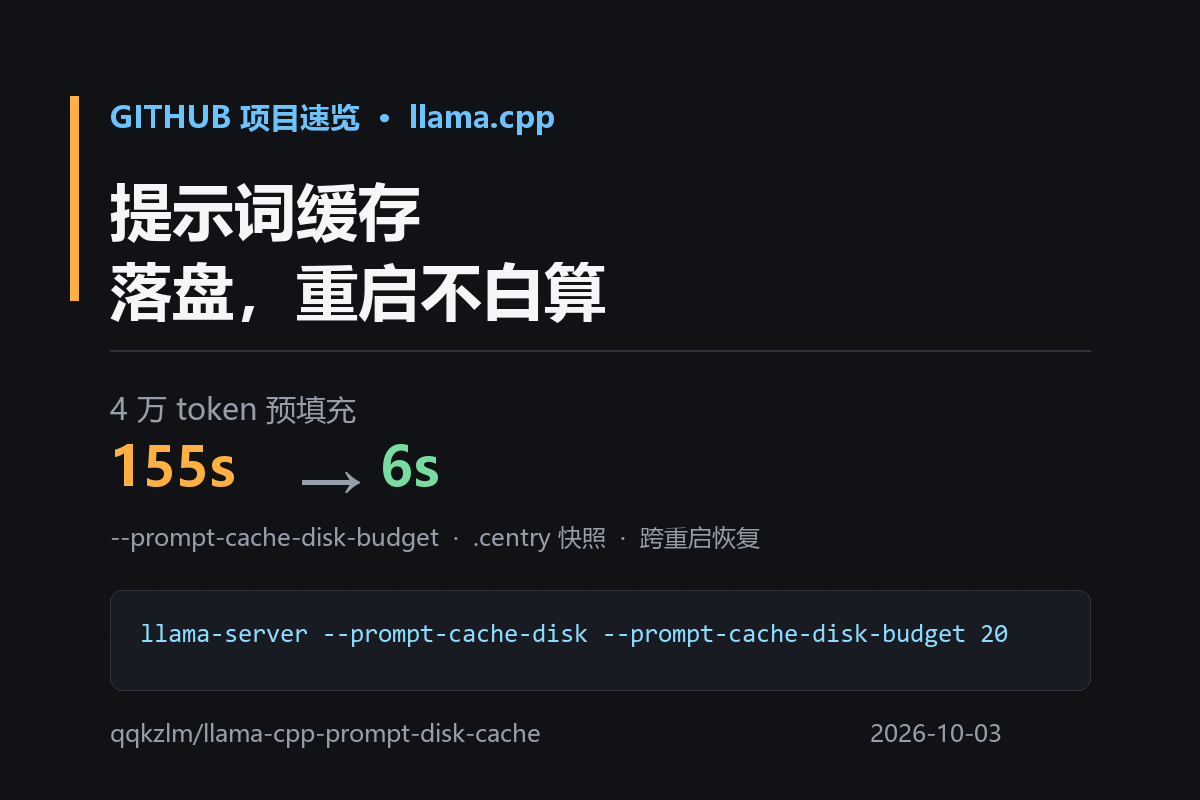


跑本地大模型的智能体(agent)大概都遇到过一个尴尬:一段长对话已经算好的 KV 缓存,只要服务重启、或者换个进程拿到同一段提示词,就得从头再预填充一遍。4 万 token 的上下文,在单张 GTX 1080 上要 151 秒才能算完——而这笔钱其实昨天已经付过了。
GitHub 上的 qqkzlm/llama-cpp-prompt-disk-cache 就是冲着这个问题去的:它给 PrismML 的 llama.cpp 分支加了一个持久化提示词前缀缓存,把 KV 缓存前缀写进磁盘,重启后自动读回来,跳过已经算过的预填充。
它解决的是什么问题
长跑型 agent 会话每次请求都会把整段不断变长的对话重新发一遍。llama.cpp 本身有内存里的 sliding window / 上下文检查点,但进程一关就没了。这个补丁把「前缀已经算好」这个事实存到磁盘上,形成一个可复用的 checkpoint:
- 跨重启恢复会话:服务启动时,自动把匹配提示词的最新检查点读回 KV 缓存。
- 增量前缀保存:对话每增长超过
--checkpoint-min-step个 token,就写一份新的.centry快照,下次请求复用最长的已缓存前缀。 - 配置签名保护:检查点按「模型 + 上下文长度 + KV 量化」打键,配置对不上的条目会被忽略,而不是被错误复用导致输出异常。
- 磁盘预算:超过
--prompt-cache-disk-budget后自动淘汰旧条目。
性能:4 万 token 从 155 秒到 6 秒
作者在 GTX 1080 8GB、Qwen3.6-35B-A3B-NVFP4-Q4_K_M、-c 92160、4 万 token 的智能体提示词上实测,冷启动和命中缓存的对比很直观:
| 指标 | 冷算(无缓存) | 完整前缀命中 |
|---|---|---|
| 预填充 40K | 约 151 秒(265 tok/s) | 1.35 秒(仅重算 32 个 token) |
| 解码 | 24–28 tok/s | 22–28 tok/s(全程稳定) |
| 端到端 | 约 155 秒 | 约 6 秒 |
| 磁盘开销 | 1.5 秒写入 | 2.1 秒读取+恢复(仅重启后首次) |
换句话说,重启后第一次请求的预填充成本,从「分钟级」直接掉到「秒级」。仓库里还给了 Qwen 3.6 在 32K 上下文下的日志实测表,冷提示词 9128 token 要 32.5 秒,而磁盘恢复后的请求只用 0.59 秒(复用 9124 个 token,只重算 4 个)。
怎么开起来
它是一个叠加在 PrismML prism 分支之上的单提交补丁(也可以从 Releases 里拿 .patch 文件),在 llama-server 上加几个参数即可:
llama-server -m model.gguf -c 32768 \
  --slot-save-path D:/kvstore/mymodel \
  --checkpoint-min-step 4096 \
  --ctx-checkpoints 64 \
  --prompt-cache-disk-budget 20
Windows 上路径写成 D:\llama-cache\qwen 这种形式,缓存目录和它的 pdcache 子目录会自动创建。缓存绑定到模型指纹、上下文大小、Flash Attention 设置和 KV 类型,所以换配置不会读到脏数据。
几个值得注意的工程取舍
- 默认走完整快照,而不是增量:对于带循环状态或 SWA 的混合模型,可复用的前缀必须包含完整序列状态。作者干脆把
--prompt-cache-disk-prefix-only禁用了——开启会直接报错,因为旧的「部分检查点」实现可能出现「报告命中、实际续写不同」的情况。在没做出正确性可验证的非阻塞实现之前,宁可不给这个开关。 - 单 slot 切换对话不再靠
f_keep猜:以前一个 slot 从对话 A 切到 B 时,只要新旧提示词仍有 60% 以上重合,就会被判成「同一段对话」而跳过落盘。现在改成显式判断:先保存当前 slot 快照,再在内存和磁盘里找最合适的兼容快照,恢复更长的可用前缀,只重算后缀。 - 检查点间距可分段配置:
--checkpoint-min-step控制均匀间距(起点建议 2048,磁盘吃紧就用 4096),也支持--checkpoint-range*按 token 位置分段设不同粒度。
MoE 分层的一条实战经验
README 里专门记了一条同机实测教训:专家留 GPU,KV 跟层走。在混合模型上把 20 层 MoE 搬到 CPU 会让预填充从 265 tok/s 崩到 30 tok/s、解码从 24–28 掉到 4 tok/s;正确做法是保持 -ncmoe 0 配 --fit,并不要给带 KV 的层加 --no-kv-offload(40 层里只有 10 层带 KV)。
适合谁
- 跑长会话 agent、又需要频繁重启
llama-server的人; - 本地单卡、显存紧但磁盘宽裕的开发者;
- 想研究 KV 缓存持久化 / 前缀复用实现细节的人——核心代码在
tools/server/server-prompt-disk.cpp(约 900 行)+ slot/task 集成,配 完整参数文档。
项目目前处于实验阶段,MIT 协议,基于 PrismML 的 llama.cpp 分支。注意 fork 的 ggml-* 库不能和官方 llama.cpp 混用。如果你正被「重启一次、重算一次」折磨,这个补丁值得试。






cqlbgzs@163.com 1年前0
d好879445037@qq.com 2年前0
购买了 无法下载Alexcc 3年前0
强大Alexcc 3年前0
看不了教程Alexcc 3年前0
雷刺下载Alexcc 3年前0
下载Alexcc 3年前0
下载dsa456159 3年前0
下载