

Leviathan:给 AI Agent 装上「数据集深记忆」,百万条记录里只取相关的那几条,token 只要 grep 的两百四十五分之一
让 AI Agent 去查一份很大的数据——几万条工单、几百万行日志、几年的维护记录——它通常只有两个办法:要么把整份数据读进上下文(几亿 token,直接爆掉),要么用 grep 在实体名下捞出全部历史(几十万 token,其中九成是噪音)。两种办法都在烧 token,而且真正的答案经常被淹没在一堆例行公事的记录里。
Leviathan 换了个思路:它不是让 Agent 去「读」数据,而是先把数据集建一次索引,之后 Agent 用大白话提问,它只返回少数几条被排序、被引用的记录卡片,任何数据规模下每次回答大约 450 token。项目 2026 年 10 月 5 日建仓,几天内冲到 660+ 星,用 Rust 写成、Apache-2.0 协议,只有一个静态二进制。项目地址:github.com/elstongun/leviathan。
它到底解决什么问题
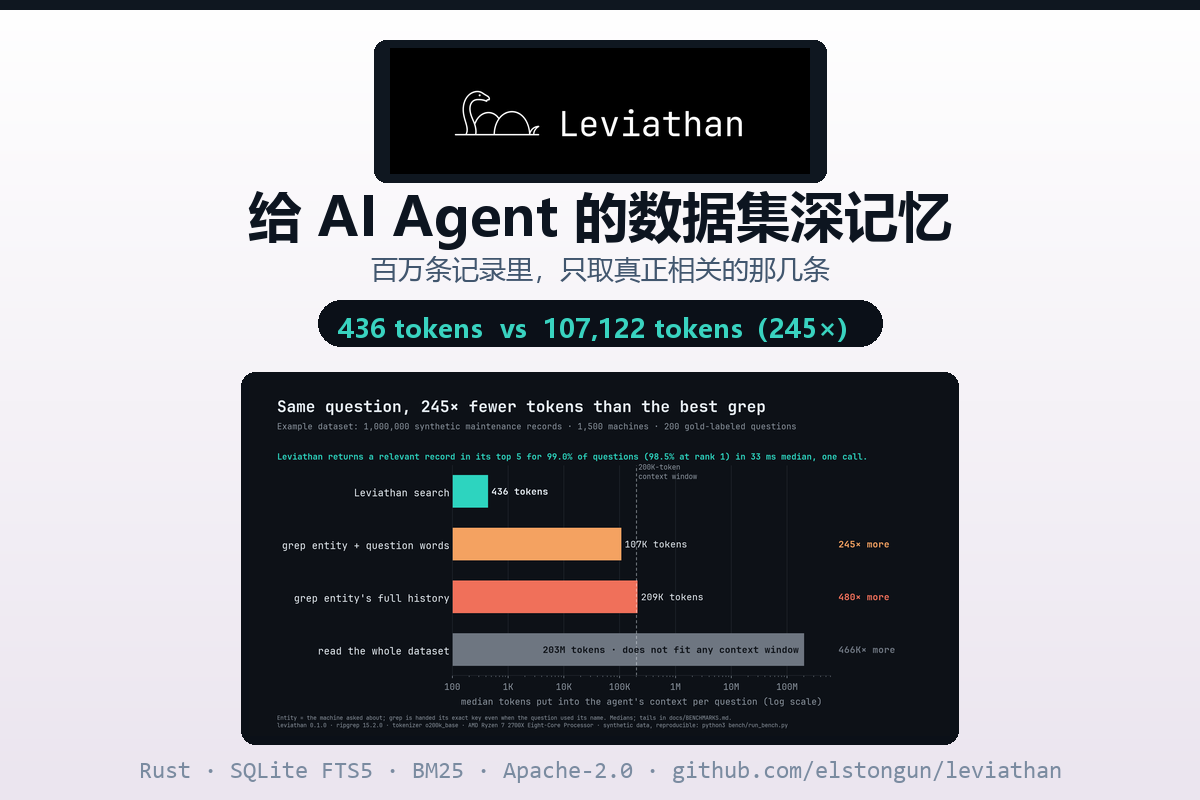
大模型的上下文窗口再大也是有限的,而真实世界的数据集往往超出它几个数量级。项目给的基准测试很直观:在 100 万条记录(678 MB)的合成维护日志上,问同一个问题——「这台机器上次是怎么修好的」——
| 100 万条记录(678 MB) | Leviathan | 最好的 grep 策略 |
|---|---|---|
| 每次问题中位 token | 436 | 107,122(245 倍) |
| 返回相关记录的比例 | 99.0%(top 5)· 98.5%(rank 1) | 96.0%(30K 字符输出内) |
| 最坏情况(1200 个问题) | 602 token | 970 万 token |
| 中位延迟 | 33 毫秒 | 92 毫秒 |
换句话说,把 20 万 token 的上下文窗口塞爆的查询,Leviathan 用不到 500 token 就给出了更准的答案,而且快了三倍。测合成数据的脚本也在仓库里(bench/run_bench.py),一条命令就能复现。
装一次、建一次索引,之后即问即答
整个流程三步。先装:
cargo install leviathan-index # 或者:cargo install --git https://github.com/elstongun/leviathan然后进到示例目录建索引,再直接提问:
cd examples/tickets && leviathan index
leviathan search -g acme "sso login loop after password reset"
返回的是一张很短的结果卡片,带编号、日期、相关度、命中的原文片段,像这样:
leviathan search · customer C-ACME "Acme Corp" (7 tickets) · query "sso login loop after password reset" · shown 3 of 3 · 24 tickets indexed
[1] T-1001 · 2024-01-08 09:12 · rel 16.9
  Login loops back to sign-in page after password reset
  status: closed · priority: high
  resolution: Cleared stale session cookies on password reset; shipped in 4.2.1.
  match: Users who reset their password get redirected to the sign-in page again in an endless loop.
注意卡片头部的 shown 3 of 3——它让 Agent 能区分「没找到」和「没数据」,这一点在自动化里很重要。
什么数据都能喂,不用改代码
支持 JSONL、JSON、CSV/TSV、SQLite,以及任何数据库命令行工具导出的结果。字段用「路径」描述(a.b、items[].name),除了 id 之外都不是必填。每个字段管什么,README 列得很清楚:
| 字段 | 作用 |
|---|---|
id |
支持 get、upsert、delete 和引用标注 |
title / text |
卡片标题(权重 2 倍)/ 被检索的文本(默认:所有字符串) |
group / group_name |
-g 限定搜索、名称解析、带标签的回退 |
date |
支持 --since、--until、recent |
filters / display |
--where 精确筛选 / 卡片上展示的字段 |
empty_values / rank.boost |
占位符视作缺失 / 偏好内容完整的记录 |
数据库也不用 Leviathan 接触凭据,用数据库自己的 CLI 把数据通过管道喂进来即可:
psql "$DATABASE_URL" -At -c "SELECT row_to_json(t) FROM tickets t" | leviathan index - -c tickets.toml
leviathan index app.db --sql "SELECT * FROM tickets" -c tickets.toml
duckdb -json -c "SELECT * FROM 'events/*.parquet'" | leviathan index - -c events.toml建索引是原子的,数据没变就跳过;upsert 和 delete 可以让索引保持最新。它读取数据,从不写入源文件。
像 Agent 一样思考的搜索语义
Leviathan 把「Agent 用起来顺不顺手」放在很重要的位置。几个设计细节:
-g接受键、名称或部分名称;组名不明确或不存在时,会列出候选并以退出码 3 结束,绝不瞎猜。- 在指定组里没找到,会回退到其他组,并把结果标成
OTHER CUSTOMER(或其他组名),让 Agent 知道这条来自别的实体。 - 可以组合使用
--where field=value、--since/--until、"短语"和-排除词。 - 退出码设计得让程序好判断:
0成功(含零命中)、1错误、2请求有误、3组名未知或有歧义。
索引本身是一个 SQLite 文件,没有运行时依赖。搜索走 FTS5 全文索引,把组名和筛选值都做成索引 token(不做事后过滤),按 BM25 × 加权排序,只把排名最高的 N 条解码成有字数上限的卡片。每条记录的组名会从限定匹配里排除,占位符按缺失处理。
接进你的 Agent:CLI 或 MCP 都行
推荐的方式是 CLI 加技能文件:任何能用 shell 的 Agent 都能调它。把仓库里的 skills/leviathan/SKILL.md 拷进 ~/.claude/skills/,或者粘进 AGENTS.md / .cursor/rules 即可,在用到之前不消耗 token。协议为 Apache-2.0,可商用、可自托管。
也可以走 MCP:leviathan mcp 会以只读的 stdio 方式提供四个工具(search、resolve_group、get、describe),它们的描述里带上数据集的摘要(每会话约 640 token)。用 leviathan wrap <claude|cursor|codex|vscode|gemini|windsurf|generic> 就能打印出对应配置。
命令表
| 命令 | 作用 |
|---|---|
init / index / upsert / delete |
推荐字段映射 / 建索引 / 更新 / 删除记录 |
search [-g G] [words] |
返回排序后的记录(支持 --scope、--where、--since、--until、-n、--offset) |
recent · resolve · get · describe |
最新记录 · 组名候选 · 完整记录 · 索引摘要 |
mcp · wrap <agent> |
MCP 服务 · 生成 Agent 配置 |
映射关系还有一个省事做法:leviathan init 会抽样最多 2000 条记录,给每个字段路径做统计(出现频率、不同值数量、长度、是否像日期),然后自动推荐 id、date、group、title、filters、text 各用哪个字段,每一个选择都带着注释写明理由。你可以像审一个 PR 那样审这份配置再定稿。
顺手聊聊它的取舍
Leviathan 不是「万能记忆」,它的边界写得很清楚:它做的是在一个已经建好索引的数据集里做精确、可引用的检索,而不是语义问答或知识推理。数据更新要显式 upsert,它不是实时同步的数据库。这些取舍反而让它保持轻量——一个静态二进制、一个 SQLite 文件、零运行时依赖,离线可用。
作者在 CONTRIBUTING.md 里还立了个规矩:任何影响排序的改动都必须附上改动前后的基准数据。这种「先证明再合并」的态度,对于检索类项目来说相当难得。
小结
当 Agent 开始处理真实规模的数据,「怎么把数据喂进去」正在变成一个比「模型有多强」更实际的问题。Leviathan 没有去堆功能,而是把一件事做到极致:用一次索引,把「读一百万条」变成「取几条」。245 倍的 token 差距、33 毫秒的延迟、99% 的命中率,交给 Agent 的就是干净、带引用、可信的那几条记录。如果你的 Agent 正在被大数据集拖慢,或者干脆因为数据太大而查不动,这值得一试。仓库地址:github.com/elstongun/leviathan。






cqlbgzs@163.com 1年前0
d好879445037@qq.com 2年前0
购买了 无法下载Alexcc 3年前0
强大Alexcc 3年前0
看不了教程Alexcc 3年前0
雷刺下载Alexcc 3年前0
下载Alexcc 3年前0
下载dsa456159 3年前0
下载