

如果你的公司同时在用 PostgreSQL、Stripe、PostHog、WorkOS、S3 和各种 API,那你大概体验过这种痛:每个系统里都能看到「客户」,但没有一个地方能告诉你这些客户到底是不是同一个人、他们贡献了多少收入、又卡在哪个环节。想要一个「公司数据全景」,通常意味着上一套 BI 或者数据仓库,然后交给云厂商托管,顺便把敏感数据也交出去。
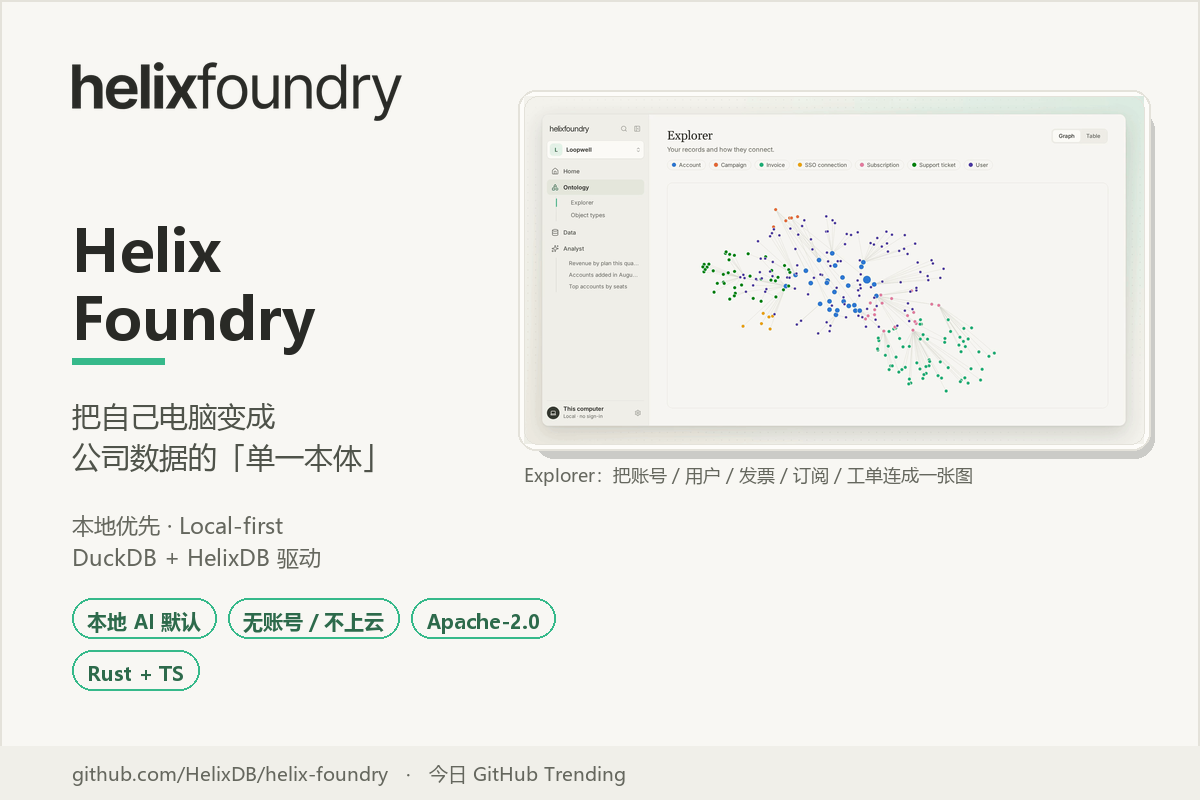
今天 GitHub Trending 上冲到近千星的新项目 Helix Foundry,提供了一个完全不同的答案:把公司数据连成「单一本体(ontology)」,整套东西都跑在你自己的电脑上,AI 默认也在本地推理。它由 HelixDB 团队开源(Apache-2.0),构建在 HelixDB 与 DuckDB 之上,不注册账号、不部署服务器、不联网也能用。
它到底解决什么问题
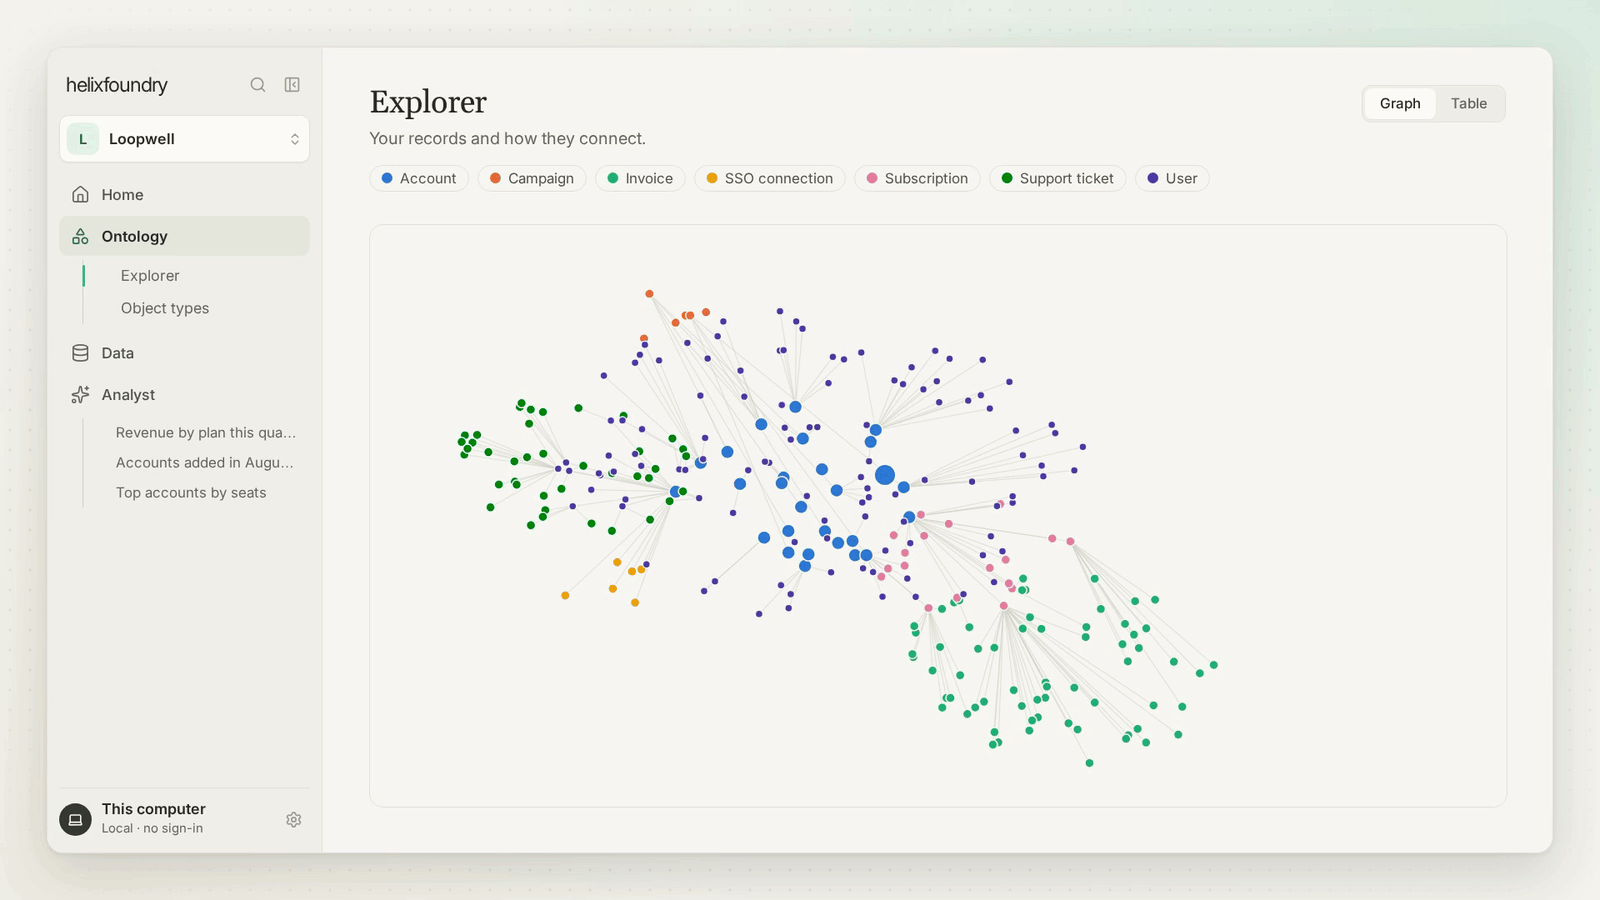
传统做法是把各系统的数据抽到数据仓库,再让分析师写 SQL、建宽表、定义指标。Helix Foundry 的思路是「先连接、再建议、再确认」:你把数据源接进来,它会自动建议一套跨数据源的实体与关系(也就是 ontology),你确认或微调之后,它就发布成一个可探索、可提问的数据工作区。
- 连接器:Neon、Supabase、PlanetScale、PostgreSQL、MySQL、Stripe、WorkOS、PostHog、REST API、兼容 S3 的对象存储,以及 CSV / JSON / JSONL / Parquet 文件上传和批量导入 API。
- 自动同步:数据库支持时走原生 PostgreSQL / MySQL 变更捕获,否则按计划做快照刷新。
- 建议本体:把不同来源里指向同一个人/客户的记录匹配起来,在 HelixDB 里存成真实的对象与关系。
- 版本化数据:不可变的 Parquet 快照,带 profile、schema 漂移审查和历史,由隔离的 DuckDB 进程查询。
- Home 与 Analyst:首页给出关键指标;用自然语言提问,答案附带实际执行过的 SQL 和快照引用。
「本体」是怎么自动长出来的
这是整个项目里最值得说清楚的一环。引导式安装只有三步:AI → Data → Ontology。
先选 AI(本地 qwen3:4b,或 Claude / OpenAI),再接数据源或直接选「用示例数据继续」。到了 Ontology 这一步,Helix Foundry 会基于你数据的 schema 计算出一套确定性的建议:把跨来源的实体按匹配键合并,并推断它们之间的链接。AI 就绪时,后台只会重写这份建议的摘要、描述和关系命名——结构本身是确定性的,不是模型随手编的。你重命名或排除实体,点「Looks right — build my workspace」,构建过程不调模型,按阶段公开进度,最后原子性地发布。
README 里的示例数据把虚构的 B2B SaaS 公司 Loopwell 从 PlanetScale、WorkOS、PostHog、Stripe 和 S3 五个系统里「连」了进来,共 11 个互相链接的数据集,同一个客户在每个系统里都出现,并带有需要人工核对消解的真实差异。这正是「本体」要解决的问题:不是把表堆在一起,而是把同一个业务对象从多个系统里认出来。
架构:五个服务,一条隔离链
项目用 Docker Compose 编排五个服务,职责划分得很清楚:
| 服务 | 职责 |
|---|---|
| App | React 界面、仅监听回环地址的 API、API Token 校验、发布与操作 |
| Worker | 持久化的 AI 运行、计划导入、流水线执行、主动生成提案 |
| Executor | 一次性的 DuckDB 子进程,只跑声明的输入与隔离的 SELECT |
| HelixDB | 工作区元数据、API Token、任务、提案、本体对象与边 |
| Ollama | 本地结构化推理与持久化模型存储 |
Compose 模式下只有 App 发布端口,而且只在 127.0.0.1 上。执行器(Executor)独自待在没有任何外网访问的内部网络里:它没有连接器凭据、没有 API 凭据,只加载被批准的输入快照,禁用外部访问和扩展安装,并把你生成的 SQL 包成单条 SELECT。同时运行的 DuckDB 任务上限为 2 个,每个 512 MB 内存,超出部分写到数据卷上的 spill 文件。在 Compose 里执行器容器被限制为 2 GB 内存、128 个进程,丢弃所有 Linux capabilities,且无法获取新权限。
安全模型:为「一个人一台电脑」设计
这是它最鲜明也最需要说清楚的设计取向:没有账号、没有登录,所以谁能访问到这个应用,谁就控制所有工作区。它为此做了几件防御:
- App 只发布在回环地址,文档明确警告不要用反向代理、隧道或端口转发把它暴露出去;HelixDB、Ollama、Executor 的端口也必须保持私有。
- API 会拒绝
Host不是本机的请求,以及任何来自其他 origin 的浏览器写操作,返回403——这能挡住 DNS rebinding 攻击。 - 默认按 IP 限流 240 次/分钟。
- 连接器与模型凭据用 AES-256-GCM 加密,密钥派生自
.env里的ENCRYPTION_KEY;脚本和 SDK 用工作区级、默认只读、可撤销的 API Token。
换句话说,它不是「把私有部署做得像 SaaS」,而是干脆承认这是一个单机工具,并把安全边界画在回环地址上。这一点在中文语境里尤其值得注意:很多人第一反应是「那我想给团队用怎么办」——项目的回答是明确的:请勿直接暴露。
实测数据:本地 AI 跑完一条完整链路
项目公开了验证记录,其中最有说服力的是一条纯本地的端到端工作流:在干净的工作区里,用固定摘要的本地 qwen3:4b,围绕「客户收入与延迟订单」的目标,模型生成了 3 条目录项、1 条 SQL 流水线、Customer 与 Order 两个本体类型、1 条关系,以及一个双组件仪表盘。自动校验修复了本草图和仪表盘草稿,十项最终检查全部通过,无需手工改组件。
发布结果:32 个客户对象、240 个订单对象、240 条客户-订单关系(覆盖全部 32 个客户)、按区域分组的收入、恰好 35 个延迟订单;每条发布的查询都在声明的快照版本上执行。总共 6 次本地模型调用、14,516 个 token、从第一个阶段到提案就绪约 153 秒。
执行器基准(Apple Silicon M1 Pro,16 GB 内存):
| 负载 | 测量值 |
|---|---|
| NDJSON → Parquet,100 万行 | 472 ms |
| 并发分析型 HTTP 客户端 | 25 |
| 执行器槽位 | 2 |
| 含排队时间的中位响应 | 1,690 ms |
| 含排队时间的最慢响应 | 3,139 ms |
项目还对比了发布一条百万记录类型的读取路径:新的物化查询以 JSON lines 读回耗时 2.1 秒;被它替换掉的旧路径要跑 2,000 条查询、每条加载并 profile 整张表(各约 196 ms),加上海量 HTTP 与子进程启动开销,大约要 6.5 分钟。这组数字很直观地说明了它为什么要用 DuckDB 隔离执行。
如何上手
最简单的路径是让编码代理替你装。前提是装好并运行 Docker(首次启动会下载几个 GB)。把下面这段话粘进 Claude Code、Codex、Cursor 或任何能跑终端命令的编码代理即可:
Set up Helix Foundry on this computer.

Clone https://github.com/helixdb/helix-foundry.git (or use the copy I already
have), cd into it, then read AGENTS.md and follow it to install, start and
verify the app. Ask me before doing anything that deletes data or stops
something that is already running. When it is ready, give me the URL and
tell me what to do next.
也可以手动跑:
git clone https://github.com/helixdb/helix-foundry.git
cd helix-foundry
./scripts/setup.sh --compose
curl -fsS http://localhost:3001/api/health
# {"ok":true,"service":"helix-foundry"}
首次运行会构建镜像并下载 HelixDB、Ollama 和 qwen3:4b 模型(约 2.5 GB),需要几分钟。就绪后打开 http://localhost:3001,跟着引导走 AI → Data → Ontology 三步即可。macOS 上如果 Docker 用不了 Metal,可以配合本机原生 Ollama 让本地推理更快。
几句实话
项目自己把短板写得很坦诚,这点在其他新项目里不多见,值得原样转述:
- Windows 未测试,安装脚本依赖 bash。
- 重写后的
backup.sh/restore.sh/upgrade.sh目前只在 stub docker 上跑过测试,还没在真实 Compose 安装上验证。 - Claude / OpenAI 的实测需要凭据,本次只有协议 fixture 覆盖。
- 16 GB 本地推理目标与 8 GB 受限安装尚缺专门的峰值内存认证;百万行基准不等于百万对象本体发布能力。
- 它目前不提供分布式事务、CDC、SSO、计费和逐记录 LLM 富化。
综合来看,Helix Foundry 值得关注的不是「又一个小数据仓库」,而是它把「本体 / 知识图谱」这件事降到了单机、本地 AI、五分钟能跑起来的粒度。它由做过 HelixDB 的团队出品,文档密度(AGENTS.md 62 KB、GUIDE 26 KB、还有 DESIGN / OPERATIONS / VALIDATION)远超一般的周末项目。如果你的工作里天天要和多个业务系统打交道、又不想把数据交给云,这个项目值得 clone 下来试一把。
项目地址:github.com/HelixDB/helix-foundry · 底座 HelixDB · 分析引擎 DuckDB






cqlbgzs@163.com 1年前0
d好879445037@qq.com 2年前0
购买了 无法下载Alexcc 3年前0
强大Alexcc 3年前0
看不了教程Alexcc 3年前0
雷刺下载Alexcc 3年前0
下载Alexcc 3年前0
下载dsa456159 3年前0
下载