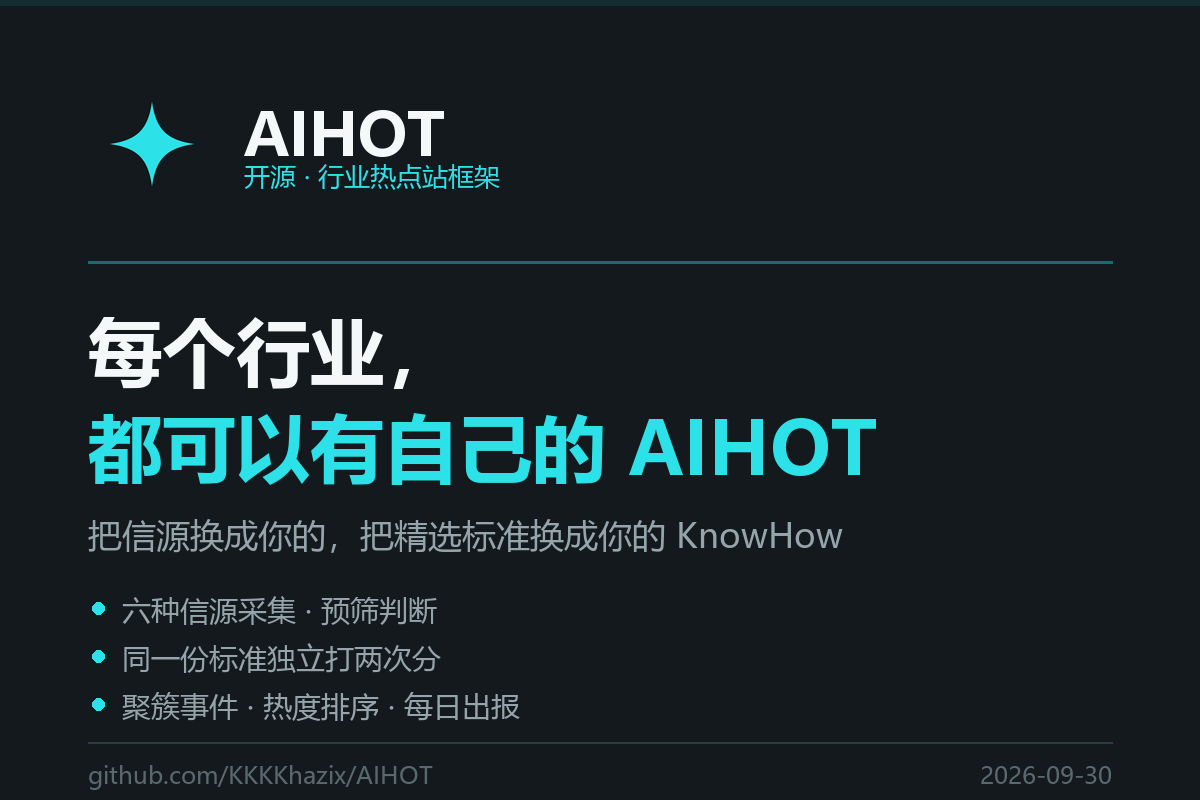


一个每天自己找热点、自己写日报的网站框架,会是什么样子?AIHOT 给出了一个相当完整的答案:它把「采集 — 预筛 — 评分 — 写作 — 聚簇 — 成刊」这一整条流水线全部开源出来,包括每一个提示词的原文和每一道入选门槛。项目在 2026 年 9 月 28 日建仓,两天内就冲到 3100 多颗星,还带一个能直接访问的线上站作对照。
作者「数字生命卡兹克」在 README 里写得很直白:这半年很多做法律、HR、金融、贵金属的朋友问他,能不能也给他们的行业做一个热点站。他做不了——因为他不了解那些行业,不知道哪些信源有用,也不知道什么样的消息才叫热点。于是干脆把整套框架开源出来,让懂行业的人自己动手。这也是项目名的由来:把站名里的 AI 换掉,它就是你的行业热点站。
仓库地址在这里:https://github.com/KKKKhazix/AIHOT,线上演示站在 https://aihot.news。
三个进程,职责分得很干净
技术栈是 Node.js 24 + TypeScript + React Router(服务端渲染)+ Fastify + PostgreSQL + pg-boss + Tailwind CSS,全部用 Docker Compose 编排。整个系统拆成三个进程:
- api(
apps/api/):Fastify 服务,扛下站内接口、公开 API、RSS、MCP、后台接口、图片代理和分享图生成。 - worker(
apps/worker/):基于 pg-boss 的任务队列与定时任务,负责抓信源、调模型、归组、算热度、出日报、发告警和清理。 - web(
apps/web/):React Router 服务端渲染的网页,只通过 HTTP 读 api,从不直接碰数据库。
业务代码集中在 packages/backend/,前后端共用的类型和常量在 packages/contracts/,而所有跟行业相关的东西——站名文案、分类标签、主题、示范信源、提示词、门槛、品牌——全部收在 industry/ 这一个文件夹里。这个边界划得相当克制:换行业基本不用动代码。
一条资料怎么变成一条精选
这是整个项目最有意思的部分。一条资料进入系统后,要依次经过这些关口:
- 收进来:同一网址、同一内容只保留一份;只有标题或订阅摘要的,先抓原文页面再判断。
预筛:判断「这是不是本行业的事」。宽进,只拦明显无关的内容,被拦下的不会出现在任何公开页面。
评分:用同一份评分标准独立打两次分(0–100)。两次之和 ≥ 2 × 门槛才入选,页面上显示的是两次的平均分。
写标题摘要:入选的、以及差一点入选的,按内容理解提示词写中文标题、答案先行的摘要、推荐理由和标签;其余的走更便宜的简短摘要,进「全部动态」。
结构化:分类、标签、主体公司、事实(谁、做了什么、对什么),和评分同时进行,主题页和事件归组都靠它。
归组:不同来源报道的同一件事归成一个事件,事件页有综述,热门按事件排。入选资料要等归组完成(最多 3 分钟)才出现,避免同一件事先冒出好几条。
成刊:每天 08:00 出日报,每周一出周报,每月 1 日出月报,按分类分节并带上导语。
其中「独立打两次分」的设计值得一提。同一份提示词、同一篇资料,让模型跑两遍,取平均——这能在不引入第二个模型的前提下,把单次波动压下去一点。门槛也不是一刀切,而是按信源分级区分:
export const SELECTION = {
  thresholds: { T1: 60, T1_5: 65, T2: 76 },
  understandFloor: 50,
} as const;
T1 是官方一手信源(官网、官方博客、机构),T1_5 是官方账号和准官方创作者,T2 是媒体与个人。官方原文门槛只要 60 分,而媒体和个人要 76 分——同样一件事,官方发布的原文更值得先看到。这组数字是 AIHOT 在 AI 领域长期在用的,作者说它「偏严:宁可少选几条,也不让噪声进精选」。
聚簇与热度:一件事只出现一次
同一件事,官网发一篇、媒体转十篇、社交平台上再吵一天——读者其实只需要看到一次。AIHOT 把这些报道聚成一个事件,分三步:
- 找候选:用标题和摘要的向量,在最近两周里找出可能是同一件事的报道,再加上同一链接、同一条推文的回复和引用。
判关系:让模型判断到底是同一件事、后续进展,还是两件事;拿不准的先合并,再换一家模型确认一遍。人工改过的归属永远不会被覆盖。
算热度:48 小时内,每个独立来源只算一次,24 小时减半;重复抓取不会多算,一家媒体发十篇也只算一次。
这套规则的结果是:排在前面的,是真正有很多人在说的事,而不是转发最多的那一家。热点榜还会跟 6 小时前的快照对比,涨得快的标上升箭头,新出现的标一个「新」字。
信源是这套系统的入口
AIHOT 支持六种信源类型,基本覆盖了内容分发的所有主要形态:
| 信源类型 | 说明 |
|---|---|
| RSS | 最常见的订阅源,直接解析 |
| 网页列表 | 没有 RSS 的站点,抓列表页 |
| JSON 接口 | 直接对接后端 API |
| X 账号 | 追踪特定账号的推文,讨论也算进热度 |
| 微信公众号 | 中文语境里绕不开的一环 |
| 外部推送 | 你自己的脚本把内容推进来 |
信源还要分「级」:T1 官方一手、T1_5 官方账号、T2 媒体与个人,另外还有一个 EXCLUDE_MP 级——它不参与精选评分,只进「全部动态」。抓取频率也不是固定的,系统会根据每个源的产出情况自动调整:活跃的源 15 分钟看一次,不活跃的自动拉长间隔。
校准:先改标准,再动门槛
换了行业、改了评分标准,怎么知道模型选得准不准?项目给了一套完整的评测流程。你先从自己的信源里挑 100–200 条资料,一条一条标「该选 / 不该选」,存成 .data/gold.jsonl,然后跑:
node --env-file=.env scripts/eval-selection.ts \
  --gold .data/gold.jsonl --split development --label "第一版评分标准"
它会输出准确率、查准率、查全率,还会把门槛从 40 到 90 每隔 2 分跑一遍,告诉你不同门槛各会得到什么结果,判错的条目连同模型给的理由一起写进后台的 SelectBench 面板。
作者给的建议很实在:该选没选上,多半是评分标准里没说清它为什么重要,就把这类价值写进「必须正常评价」的部分并给出例子;不该选却选上了,多半是噪声没压住,就写进「必须压住」的部分;只有整体偏松偏紧、且判错的条目分数都贴着门槛时,才去调门槛。「先改标准,再动门槛:门槛只能整体移动,解决不了哪一类判错了。」
评测还刻意区分开发集和留出集:调提示词时只看开发集,最后再用留出集检查一遍,免得把提示词调成「只会做这几道题」。另外,同样的输入和提示词重跑不会重复调用模型——因为每个付费请求都有一张回执,改过的部分才会产生新调用。
几个工程上很克制的设计
- 一个公开读取层:网页、RSS、API、MCP、站点地图、分享图读的都是
packages/backend/src/publication/,所以各个出口看到的内容天然一致。新增出口也从这里读。
页面不调模型:读者打开页面只读数据库里已有的结果,模型只在 worker 的任务里调用。这是响应速度的底气——线上实测页面中位数 10 毫秒,95% 在 50 毫秒内。
花钱的请求有回执:每个付费请求(模型、X、公众号、Jina)先记一张回执,拿到结果先存再用。进程重启、任务重试时复用已经付过钱的结果,不重复花钱。
预算熔断:每个付费服务有每分钟、每小时、每天的上限,超了就暂停,在后台「设置 → 预算」里配。
旧文不刷屏:发现时已发布超过 48 小时的资料、新信源的存量、回灌的推送,按原文时间归档,不进「今天」、不推送。
来源可追溯:每条精选都链接原文,站内是否显示全文由信源的配置决定,默认只显示摘要。
它给你留了哪些出口
除了给人看的网页,这套框架还准备了相当完整的机器接口:
| 出口 | 内容 |
|---|---|
/ /all /hot /topics | 精选、全部动态、热门事件、主题页 |
/daily /weekly /monthly | 日报、周报、月报 |
/feed.xml 等四个 | RSS:精选、全部、全文、日报 |
/api/v1/ | 公开 API,文档在 /openapi-v1.json |
/api/mcp | MCP 服务,工具名前缀可配(默认 myhot_) |
/llms.txt | 给大模型看的站点说明 |
/admin | 后台:信源管理、内容诊断、精选评测、模型切换 |
「同一份内容,既给人看,也给 Agent 用」——在 2026 年,这个设计思路越来越像标配,但真正把 MCP、llms.txt、公开 API 和 RSS 一起做齐的站点框架并不多。
十分钟把它跑起来
需要 Docker,和一个 OpenAI 兼容的模型 API Key(DeepSeek、千问、智谱都可以):
git clone https://github.com/KKKKhazix/AIHOT.git myhot
cd myhot
node scripts/init-env.ts --llm-key <你的模型 API Key>
docker compose up -d --build
打开 http://localhost:3000 就能看到站点了,后台在 /admin,管理员密码在 .env 的 ADMIN_PASSWORD 里。一两分钟后开始有内容,第一次导入的资料大约半小时处理完。仓库里自带 18 个公开的海外 AI 资讯源作示范——注意,真正的信源名单和运营数据并不在仓库里,要换成你自己行业的。
改成你的行业,交给 Agent 就行
最省事的办法:把仓库丢给你的编码 Agent(Claude Code、Codex 都行),然后说:
请读 AGENTS.md 和 docs/customize.md,把这个站改成「法律」行业的热点站。我关心的是……(你想盯哪些信源,你觉得什么消息重要、什么不重要,越具体越好)。
要改的东西几乎都在 industry/ 里,代码基本不用动:site.ts 管站名和文案,taxonomy.ts 和 topics.json 管分类标签主题,sources.json 管首次启动时导入的信源,prompts/ 放你的行业 KnowHow,selection.ts 管入选门槛,features.ts 是模型榜和 Codex 重置监控的开关。
作者特别提醒:最值得花时间的是评分标准和门槛,而不是界面。这也是把「行业 KnowHow」真正沉淀下来的地方——它不在代码里,而在你怎么定义「什么值得看」。
一点观察
AIHOT 有意思的地方,在于它把「内容运营的判断力」当成了可配置、可评测、可迭代的一等公民。提示词有版本(版本号就是内容的哈希)、判断有门槛、门槛能校准、校准有样本集和评测脚本——这套工程化的做法,通常在推荐系统或者搜索团队里才见得到,而现在它被装进了一个开源的热点站框架。
作者自己也说得很清楚:他不是专业开发者,是设计师出身,半年前还看不太懂代码,这套代码是他和 AI 一起重写的,「一定还有写得不好的地方」。这反而让整个项目更有参考价值——它展示的是一个普通人在 AI 辅助下,能做出什么样完整度的东西。MIT 许可,代码可以随便用,只要求你不要用 AIHOT 的名字和 Logo。
如果你一直想给自己所在的行业做个信息聚合站,又卡在「不知道从哪下手」,这个仓库大概是目前最接近「照着抄就行」的一份参考。https://github.com/KKKKhazix/AIHOT






cqlbgzs@163.com 1年前0
d好879445037@qq.com 2年前0
购买了 无法下载Alexcc 3年前0
强大Alexcc 3年前0
看不了教程Alexcc 3年前0
雷刺下载Alexcc 3年前0
下载Alexcc 3年前0
下载dsa456159 3年前0
下载